AI网址导航


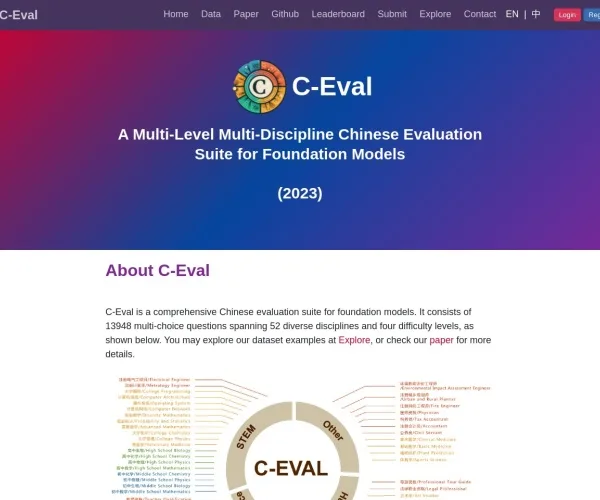
C-Eval 用中文学科考试题来衡量大语言模型的知识与推理水平,测试内容按 STEM、社会科学、人文科学和其他门类分组展示,并单独设有难度更高的 Hard 子集,用来拉开头部模型的差距。评测支持零样本和少样本两种设置,成绩细化到各学科分项;模型团队可以提交预测结果,由系统自动计算分数并进入排行榜,榜单还区分了可公开验证的模型和受限访问的模型。
它适合正在研发或选型中文大模型的团队,用来在统一口径下横向对比不同模型的中文能力,也适合研究者和关注国产大模型进展的读者查看阶段性排名。需要注意的是,C-Eval 团队也在页面上提醒,任何评测都有局限性、榜单可能被刷分,因此更适合把它的成绩当作参考维度之一,而不是判断模型好坏的唯一标准。
©️版权声明:若无特殊声明,本站所有文章版权均归AI工具集原创和所有,未经许可,任何个人、媒体、网站、团体不得转载、抄袭或以其他方式复制发表本站内容,或在非我站所属的服务器上建立镜像。否则,我站将依法保留追究相关法律责任的权利。
类似网站


AI工具箱收录了国内外数百个不同类型的AI工具,每日更新和添加最新AI工具,AI工具集还推荐了AI学习开发的常用网站、框架和模型,帮助你加入人工智能浪潮,自动化高效完成任务!
Ctrl + D 或 ⌘ + D 收藏本站到浏览器书签栏。
关注我们